265 angela Snaeffelsjökuls rawling
interdisciplinary artist


Audioscoring als praxisorientierte Forschung fokussiert auf das Zusammenspiel von experimentellen Stimmen und Aufnahmetechniken.
L’audioscoring, en tant que recherche axée sur la pratique, se concentre sur l’interaction entre les voix expérimentales et les techniques d’enregistrement.
Audioscoring as practice-orientated research focuses on the interaction of experimental voices and recording techniques.
265 angela Snaeffelsjökuls rawling
interdisciplinary artist
264 261002 Audioscoring BarDem Kommentar
for english please scroll down
Glamouröses Filmfestival Zürich. Dafoe sei eingeladen worden und also auch Carson. Das hingegen erstaunt mich. Womit konnte man sie überreden? Komparatistik, der Schwenk, der Cut, Arbeiten mit der Totalen? Warum sollte ich das wissen wollen. Carson ist gekommen und basta. Als auf meine Anfrage ein Kommentar von ihr im Chat auftaucht, habe ich mir ein Glas Wein eingeschenkt. Sie blickt kurz auf. Mit Schummeln ist bei ihr kein Durchkommen. Entweder du trinkst Wein oder du tauchst diesen fusseligen, alten Teebeutel ins heisse Wasser. Für ein Gespräch mit Carson nach Mitternacht ist der Tee recht bitter.
Ich möchte ihr erklären, was es Audioscoring auf sich hat. Sie sitzt unbequem auf dem Küchenstuhl. Yes, my dear, let’s hear. Das wird nicht lange dauern, fürchte ich. Mit Audioscoring formiere sich eine Art Zeugenschaft im Zuhören. Wie bitte?, so Carson. Mit diesem Tonfall muss ich erst fertig werden. Ich müsse mehr über das Konzept des Audioscorings herausfinden und über seine performative Umsetzung, auch musikalisch. Wie klug, wie schlau sind die Vorgaben? Oder nützen sich diese ab und verblassen zum Konzept? Was ist von den Stimmen auf dem Band zu hören? Ist das offenkundig misslingende Unisono eine gelungene Sache? Flinkes Hinterher oder flappsiges Immer-zu-spät. Was jetzt? Wunderbare Vergeblichkeit. Während die Aufnahme läuft, angespannt den Stimmeinsatz antizipieren. Und verpassen. Wie lange dauert die Atemzäsur? Synchronizität wird so nie gelingen – ein strukturelles Problem. Zwangsläufig scheitern. Aber der Versuch, dieses grossartige Trotzdem, geht das nicht zu Herzen? Dieser Wunsch das Timing zu verinnerlichen, sozusagen mit absoluten Zeitempfinden zu operieren, mit dem siebten Sinn. Woher diese Zuversicht? Naiv. Carson lässt sich nichts anmerken.
Sommerferien, Wandern, Schneeberge, Balkongeländer mit ausgefrästen Herzen, Aufsatzhefte im Schatten der Herzen. Es sind nicht meine Aufsatzhefte. Ich gehe noch nicht zur Schule, schreiben habe ich noch nicht gelernt. Das Heft liegt aufgeschlagen auf einem kleinen Tisch. Ich soll die Schnürchenschrift, die blaue Tinte nachziehen mit einem roten Bleistift. Doppellinien, auch die Satzzeichen. 32 Seiten, mit dem Löschpapier sind es 33. Dazu die Korrekturen und die Noten zum Schluss der Seiten. Sind sie rot, dann zeichne ich rot in rot. Stolz schreiben zu können. Es genügt, es fehlt nichts. Es schreibt.
Meist vergebliches Bemühen die Stimmen der Aufnahme in Echtzeit nachzumachen, aber Spass machts, sich eine andere Stimme einzuverleiben, als wäre es je möglich eine andere als die eigene Stimme zu haben. Was halten sie davon Frau Carson? Die stimmphysiologischen Verschiedenheiten treten offensichtlich hervor, Männerstimmen, Frauenstimmen, aber nicht immer: das Erstaunlich der perfekten Überlagerung, je mehr sie gelingt desto unhörbarer. Wenn Stimmen ineinander verschwinden.
Redoing, Reperformance, Verkörperung, ein durchschaubares Spiel mit der An- und Abwesenheit der Stimmen oder mehr? Carson sollte auch wissen, dass Audioscoring BarDem für das Festival BarDem manifest BarDem konzipiert wurde, auch im Wissen, dass Vincent und Jacques zuhören werden. Als Überraschung, für das Fest von BarDem, ein konkretes «manifeste» wie sich BarDem gewünscht haben. BarDem beim Wort nehmen. Carson rückt die Brille zurecht. Es fühlt sich in der Performance aber wie eine Grenzüberschreitung an. Kein gutes Zeichen. Worüber sinniert Carson? Ernsthaft, über Stimmenimitationen? Ich ergänze noch, es könne heikel sein, ein Tabu, Stimmen als Varianten ihrer selbst zu denken. Als etwas das gekapert werden kann, nicht nur von KI. Originale müssen mit Folgen rechnen, so das Ensemble Tzara, also auch die Stimmen, also auch die Stimmen von BarDem. Sie vergegenwärtigen sich in anderen Stimmen, verlieren ihren Status als einzigartige Stimmen. Sie werden zu Modellen. Das Erratische einer einzigartigen Stimme tauscht den Platz mit der einzigartigen Imitation.
BarDem pflegen eine ikonische Performancehaltung: in den ausgestreckten Händen die Partitur, Performance ohne eine Miene zu verziehen. Im Video ist zu sehen – soll ich es Carson zeigen? – wie unruhig und impulsiv und herausgefordert das Auswendiggelernte abzurufen ich bin, überfordert synchron zum Band zu agieren.
Audioscoring wird für jede Aufführung neu kalibriert. Audioscoring ist nicht gleich Audioscoring. Anne nickt, bis hierhin scheint sie gefolgt zu sein.
Glamorous Zurich film festival. Dafoe was invited, and so was Carson. That, however, surprises me. What could they have persuaded her with? Comparatistics, the pan, the cut, working with the wide shot? Why should I want to know? Carson came, and that’s that. When a comment from her appears in the chat in response to my question, I pour myself a glass of wine. She looks up briefly. There is no getting away with cheating with her. Either you drink wine or you dip that old, fuzzy tea bag into the hot water. For a conversation with Carson after midnight, the tea is rather bitter.
I want to explain to her what Audioscoring is about. She is sitting uncomfortably on the kitchen chair. Yes, my dear, let’s hear. This won’t take long, I fear. With Audioscoring, a kind of witnessing takes shape in listening. What? Carson asks. I first have to get past this tone. I have to find out more about the concept of Audioscoring and its performative realization, musically as well. How clever, how smart are the instructions? Or do they wear out and fade into a concept? What can be heard of the voices on the tape? Is the obviously failing unison a successful thing? Quick pursuit or flippant always-too-late. What now? Wonderful futility. While the recording is playing, tense, anticipating the voice entry. And missing it. How long does the breath caesura last? Synchrony will never succeed this way – a structural problem. Bound to fail. But the attempt, this magnificent nevertheless – isn’t there something moving about it? This desire to internalize the timing, so to speak, to operate with an absolute sense of time, with a sixth sense. Where does this confidence come from? Naïve. Carson doesn’t let it show.
Summer holidays, hiking, snow-covered mountains, a balcony railing with hearts cut out of the wood, exercise books in the shadow of the hearts. They are not my exercise books. I have not started school yet, I have not learned to write. The notebook lies open on a small table. I am supposed to trace the cursive handwriting, following the blue ink with a red pencil. Double lines, including the punctuation marks. Thirty-two pages; with the blotting paper, thirty-three. Then the corrections and the grades at the end of the pages. If they are red, I draw in red over red. Proud to be able to write. It is enough, nothing is missing. It writes.
Mostly a futile effort to imitate the voices from the recording in real time, but it’s fun to take another voice into oneself, as if it were ever possible to have a voice other than one’s own. What do you make of that, Ms Carson? The physiological differences between the voices become obvious – men’s voices, women’s voices – but not always: the astonishing thing about the perfect overlap, the more successful it is, the less audible it becomes. When voices disappear into one another.
Redoing, reperformance, embodiment, a transparent game with the presence and absence of voices, or more? Carson should also know that Audioscoring BarDem was conceived for the festival BarDem manifest BarDem, also knowing that Vincent and Jacques would be listening. As a surprise, for the celebration of BarDem, a concrete “manifeste,” as BarDemhad wished. Taking BarDem at their word. Carson adjusts her glasses. In the performance, though, it feels like crossing a boundary. Not a good sign. What is Carson musing on? Seriously, voice imitations?
I add that it might be delicate, a taboo, to think of voices as variants of themselves. As something that can be hijacked, not only by AI. Originals have to reckon with consequences, as Ensemble Tzara puts it – and so do the voices, so do the voices of BarDem. They become present in other voices, lose their status as unique voices. They become models. The erratic quality of a unique voice exchanges places with the uniqueness of its imitation.
BarDem cultivate an iconic performance stance: the score held in their outstretched hands, the performance proceeding without a flicker of expression. In the video, one can see – should I show it to Carson? – how restless and impulsive and challenged I am by having to retrieve what I have memorized, overwhelmed by the attempt to act in synchrony with the tape.
Audioscoring is recalibrated for every performance. Audioscoring is not the same as Audioscoring. Anne nods. So far, she seems to have followed.
Audioscoring BarDem
Dorothea Schürch
26. Juni 2025
Im Rahmen von BarDem manifeste BarDem
Espace Ruine, Genève
Audioscoring BarDem, Dorothea Schürch, 26. Juni 2025, Espace Ruine, Genève (Videostill)


Material:
Audioscore:
BarDem, Live on WFMU’s Miniature Minotaurs, 2011, Part 01 (Ausschnitt)
Bluetooth Lautsprecher
Notizen
Dauer: 8:04
Audio: Vincent Barras, Jacques Demierre (BarDem, Live on WFMU’s Miniature Minotaurs, 2011) | live: Dorothea Schürch
In der Singschule mit BarDem – Lat. [schola]: Musse, Ruhe; wissenschaftliche Beschäftigung während der Mussestunden; – Griech. [échein]: haben, halten, besitzen, zurückhalten usw. – der Wunsch nach einer Lektion, nach Lerngegenstände, die nicht gemeint sein können, nach dem, was keine Schule macht (in Erinnerung an die Performance Teach Me Your Lesson mit Daniel Mouthon (Zwischenräume, Sihlquai, Zürich, 2012). Von Stimmen lernen. Audioscoring BarDem zielt nicht auf analytische Forschung, sondern eine Methode sich Stimmen einzuverleiben. Endlich wieder üben, täglich. Über viele Jahre just didn’t do it anymore, to much learing by reading. Entlernen, unlearning to sing. Mit BarDem die Stimmbänder flattern lassen, tiefe Stimme durch Entspannung, Artikulationsprozesse und Atembögen mit Testosteron, Stimmfarben mit Stimmbruch. Experimentelle Stimmphysiologie.
Der Audioscore dominiert. Der Aufnahme – bis auf wenige Momente – hinterher. Für die Synchronizität fehlt der gemeinsame Auftritt. Synchronizität ist mit Audioscoring nicht haben, der Audioscore kennt keine Anspannung, kein Luftholen, einzig «play!».
Bereits zur Hälfte von Miniature Minotaurs, Part 01 erschöpft sich die Performance. Zu absehbar das Spiel mit der Imitation. Wo bleibt die Eigenständigkeit? Die Stimmen von BarDem aus dem Bluetooth Lautsprecher. Ermüdende, wenn gleich aberwitzige Transformation des Gehörten in den Espace Ruine (!). Hie und da unerwartet perfekt – das hingegen ultimativ performative, doch vergebliche Liebesmüh. Als Performance vollwertig, think! Robert Fillious «bien fait, mal fait, pas fait.»
Stimmarchive vom Play, Stop, Rewind, Forward in die physische Gegenwart holen, von der für jede noch so rauhe Stimme zarten Vibration der Membran der Lautsprecher weg. Reperforming, Redoing, Reenactment. Der Begriff Interpretation greift ins Leere. Was muss für eine Interpretation vorliegen? Vom Audioscore ausgehend gibt es keine Interpretation. Nur nachmachen. Von den Partituren von BarDem schon.
Als Performance im Rahmen von «BarDem manifeste BarDem» ein exemplarisches «manifeste», stimmig. Trotz aller Fragezeichen. Wie weiter? Weiter.
At the Singing School with BarDem – Lat.[schola]: leisure, repose; scholarly activity during hours of leisure; – Greek [echein]: to have, to hold, to possess, to restrain, etc. – the desire for a lesson, for learning materials that cannot be intended, for what no school can teach (in memory of the performance Teach Me Your Lesson with Daniel Mouthon, Zwischenräume, Sihlquai, Zurich, 2012). Learning from voices. Audioscoring BarDem does not aim at analytical research, but at a method of incorporating voices into one’s own body. Finally, practising again, every day. For many years, I just didn’t do it anymore, too much learning through reading. Unlearning, unlearning to sing. With BarDem, letting the vocal cords flutter, a low voice through relaxation, processes of articulation and breath arcs with testosterone, vocal colours with voice break. Experimental vocal physiology.
The audioscore dominates. Following the recording – except for a few moments – always late. The shared performance, the joint appearance, is missing for synchrony. Synchrony is not something one can have through audioscoring; the audioscore knows no tension, no taking a breath, only “play!”
Already halfway through Miniature Minotaurs, Part 01, the performance runs out of steam. The game of imitation becomes too predictable. Where is the autonomy? BarDem’s voices coming from the Bluetooth speaker. An exhausting, yet at the same time absurd, transformation of what is heard into the Espace Ruine (!). Here and there, unexpectedly perfect – an ultimately performative, yet futile labour of love. As a performance, fully realised: think! Robert Filliou’s “bien fait, mal fait, pas fait.”
Bringing voice archives out of play, stop, rewind, forward and into the physical present, away from the delicate vibration of the speaker membrane, which persists even with the roughest of voices. Reperforming, redoing, reenactment. The term interpretation falls short. What needs to be in place for there to be an interpretation? Starting from the audioscore, there is no interpretation. Only imitation. With BarDem’s scores, there is.
As a performance within the framework of BarDem manifeste BarDem, an exemplary manifeste, coherent. Despite all the question marks. How to continue? Continue.
Audioscoring BarDem, Dorothea Schürch, 26. Juni 2025, Espace Ruine, rue des Vollandes 15, Genf
(Clip: 2:05)
siehe auch/ see:
264 Log 261002 Audioscoring BarDem Kommentar
deutsch und englisch
BarDem manifeste BarDem
La pratique de BarDem, duo composé de Vincent Barras et Jacques Demierre, se fonde sur le son, la parole, le langage, éléments constitutifs de sa poétique, multilingue, performée, explorant la voix projetée et sa spatialisation. Une part importante de l’activité de BarDem consiste en la poursuite de collaborations, où le duo entre en résonance avec d’autres performeur·euse·s, poètes, créateur·trice·s sonores, collectifs de musique ou d’arts vivants : tou·te·s ont comme point commun de travailler, chacun·e à leur manière, sur le langage et sa matérialité, la parole projetée ; à leur tour, ils·elles s’aventurent à interroger, pirater, interpréter, traduire, répercuter, dilater le travail de BarDem. Les différentes productions qui en ont résulté, jusqu’ici inédites, sont rassemblées dans le coffret Bar & Dem &, qui associe BarDem et des artistes d’horizons divers : compositeurs se saisissant de l’œuvre du duo pour une nouvelle création (Adrien Kessler, Jacques Demierre) ; performeurs se joignant à ce dernier en ajoutant leur propre pratique oratoire (Chris Mann ; Kurt Gottschalk) ; chœur composé de communautés parlantes de langues différentes interprétant en traduction live un poème de BarDem (The Alhambra Choir); quatuor d’interprètes interagissant en simultané avec les deux performeurs (El Cuarteto de Buenos Aires) ; ingénieur du son créant des dispositifs sonores spécifiques pour la diffusion de créations de BarDem (Thierry Simonot) ; auteur·trice·s et poètes sonores de l’avant-garde historique visité·e·s par BarDem (Source: BarDem manifest BarDem, Flyer)
254 260114 Abschluss-Symposium
Schreiben mit Stimmen
9.–10. Januar 2026
Zur Wechselwirkung zwischen symbolischen und technischen Verschriftlichungspraxen in der Musik
Michael Harenberg (Leitung)
Mathieu Corajod (Doktorand)
Dorothea Schürch (Post-Doc)
Institut Interpretation, HKB, Bern
Gefördert durch den Schweizerischen Nationalfond, Abt. I
Laufzeit Februar 2022– Januar 2026
Schreiben mit Stimmen Eine Standortbeschreibung und Ausblick
Veranstaltung am Freitag, 9. Januar 2026
19:30, Papiermühlestrasse 13d, Multifunktionsraum
Zum Ende des vierjährigen SNF geförderten Forschungsprojektes „Schreiben mit Stimmen“ geben wir in dieser Veranstaltung einen Überblick über den Verlauf und die Ergebnisse der drei bearbeiteten Teilprojekte.
Ausgangspunkt des Forschungsprojekts sind vernachlässigte Aspekte der Komposition mit bzw. für Stimmen in technischen und aussermusikalischen kompositorischen Gestaltungsprozessen. Diese Fragestellungen wurden zunächst anhand der Praxis des Schweizer Komponisten Hans Wüthrich (1937–2019) sowie der (Ultra-)Lettristen im Paris der Nachkriegszeit entwickelt und im weiteren Verlauf des Projekts auf unterschiedliche internationale Kontexte und Praktiken der Stimmenkomposition ausgeweitet, sowie im Zusammenhang mit körperlosen, synthetischen Stimmen, die im Verlauf des Projekts zu einem Alltagsphänomen geworden sind.
Wie wir zeigen werden, erweitern konzeptionelle als auch technische Schreibprozesse mit und für die Stimme Entstehungsprozesse sowohl im Werk Hans Wüthrichs als auch die medialen Zugänge der Ultra-Lettristen und weiterführender Praktiken der Tonbandkomposition. Selbst da, wo eine Partitur im herkömmlichen Sinne existiert, wird mit der Stimme improvisiert, wird Stimmmaterial durch aussermusikalische Praktiken oder technische Medien, wie das Tonband, vorgebildet. «Schreiben mit Stimmen» fragt nach Kompositionsstrategien und Ästhetiken zeitgenössischer Musik, wie sie sich in diesen gesellschaftlichen und technologischen Bezügen präsentieren. Fokussiert werden vor allem kompositorische Strategien, die in Konkurrenz zur traditionellen Notenschrift stehen, da sie sich sowohl an der aufgezeichneten Stimme als auch an ihren aussermusikalischen Referenzsystemen orientieren.
Neben vielen Hörbeispielen zu den genannten Themenbereichen, werden Studierende im Rahmen der Veranstaltung Werke von Hans Wüthrich und der Lettristen live interpretieren.
Small Inner Spaces VIII
to jest moja apteca
Mazovian Museum, Płock, Polen
19. Juli 2023
Ablauf
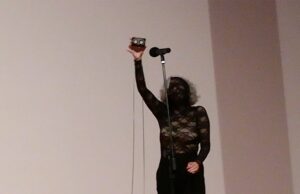
I Backstage
Stuhl zur Seite der Bühne
Plastiktasche zerknüllt, warten
Hosentasche mit Bluetooth Lautsprecher (on, ppp/Handy on)
II Auftritt
schräg, Mitte der Bühne, sich zum Publ. drehen
die Stöckelschuhe ausziehen, akurat schräg zum Bühnenrand platzieren
III Small Elevation
auf die Zehen stehen, wird der Atem hörbar
berühren hingegen die Fersen den Boden: Stille
Augen auf den Boden richten (stabiler Zehentand)
IV Schwebung
re Hand von Plastiksack lösen
langsam fallen lassen
mit einem zweiten Impuls Hand in Hosentasche (Steuerung des Vol)
Schwebung (Sinuston) abhängig von Raumakustik
V Taschen-Lunge
Übergang zu Stimme, kurz nach der Vorgabe der Geräusche der Plastiktasche
Tasche auf Boden stossen, bläht sich, dumpf wie eine Bassdrum
VI Megaphon
VII Apteca
Bühnenrand (sitzend): Apteca und Megaphon mit Loop
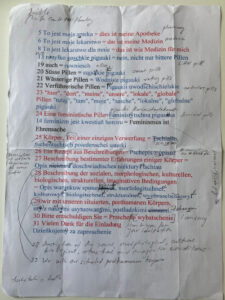
Lipsink der Polnischen Sätze/Audioscoring
VII Gespenst
Material:
Body, schwarze Hose, grüne Stöckelschuhe mit grauem Gaffertape geflickt, rot-blau-weiss gemusterte Tragtasche
Bluetoothlautsprecher (JBL Go 3), Smartphone (sweep), Megaphon, Schalldämpfer, Loop mit es1↓
K7 Gerät und K7 mit F↑, K7 präp. als Gespenst (kurze Beine)
Smartphone = Apteca (18 Sätze Polnisch, Sweep – on, mute, damit JBLautsprechern nicht ausschaltet)
Papier mit den Sätzen und Brille, kleiner Schraubenzieher und Pinzette (für Gespenst), Mikrophon und Mikständer für die stumme Ansprache des Gespensts
Dauer: 26`
Lipsink
Mit Small Inner Spaces VIII wird Audioscoring um eine Variante reicher: die Stimme der Übersetzungsapplication spricht vor und mit Lipsink wird daraus eine Ansprache auf Polnisch. Es werden 18 polnische Sätze nachgesprochen. Versuche akurater sprachlichen Artikulationen, feinhörig, jede Abweichung stört.


031 Log 221210 La Mémoire_close listening
Freihandbibliotheken (IRCAM, Bibl. Kandinsky, Oudin)
den Bestand durchkämmen und abzuschweifen mit System
Recherche in der Bibliothèque national de France BnF
unheimlich verwechsle la mémoire von Wolman mit Audioscoring von mir
Ws. konzeptueller Umgang mit Bandmaterial, keine Nachbearbeitung.
die Aufnahmen dokumentieren (vermeintlich) den exakten Verlauf und Dauer kein x-beliebig editiertes Resultat einer Aufnahmesession
kommt dazu, dass das close listening (Mikrophon Platzierung) die Nähe der Lippen (Speichel) hörbar werden lässt. Während eine filmische Dokumentation Equipment, Studiodesign, Mode, Schnurrbart, Gesten einfängt, vermittelt der Audiotrack La mémoire ein ortloses Ereignis, eine ominöse „Präsenz“ von W. im Hier und Jetzt der BnF. Wolman, der scheinbar hinter meinem Rücken hier im Chaussez Jardin der BnF agiert. Wolman „aktualisiert“: JETZT!
durch eine Videodokumentation würden (nostalgisch?) die 60ger Jahre (50ger) wieder auferstehen : den gutsitzenden Zweiteiler, das glatt gekämmte Haar
dagegen vermittelt das Audio-Archiv die körperliche Präsenz von W. ohne Kellergewölbe, ohne Nachtclub, ohne Assoziationen zu einem Jahrzehnt (Mode), unmittelbar Stimme und Körper.
Lieu de Recherche BnF_1
Lieu de Recherche BnF_2
Andrea: man muss mehr für die Rezeption tun?
Audio tut mehr und es tut es im Heute.
021 Log 221130 Carla Lonzi_Audioscoring
Dokumentarische Praktiken ausgehen von Stimmaufnahmen
Urheberrechtsprobleme Audioscoring
Un algorhythymus fait une soustraction de la voix de Wolman et de ma voix: le mieux que je fais le moins qu’on entend.
Sweetness of becoming one again
004 Log 221104 Notizen mit Andrea Saemann und Chris Regn
ZOOM
Protokoll → Andrea
Perf Saga → Vorbild Interviewführung
Kamera = stabil
Ulrike Rosenbach und Monika Günther: die ersten Gespräche in Vorbereitung für die Interviews in den USA
Andrea
Small Inner Spaces V
Uncanny Silences – Performative Mutness
Symposium
Le son dans l‘art performance
– une épistémologie Intermédia
[Pleine association en mode composé*]
Musée des beaux arts & d`archéologie, Besançon
6. April 2022
Uncanny Silences – Performative Mutness
selon Gina Pane
Action Autoportrait(s), mise en condition / contraction / rejet, 11. janvier 1973
Material
Teil I
Powerpoint Präsentation
Textkarten
Teil II
Spotlicht
Notenständer
Score
Streichhölzer
Dauer: 30‘
Uncanny Silences – Performative Muteness focuses on a voice that cannot be heard because it is held back, suppressed. A voice that evokes an uncanny silence. A performative muteness, a silence that can be felt, a physical silence, an audible absence that makes all the sounds stand out all the more. At the center of Small Inner Spaces V is the performance „mise en condition“, „the conditioning“ from January 11th, 1973 by Gina Pane, the French born performance artist who lived and worked in Paris and was a member of the 1970s Body Art movement „Art corporel“. The following description of „the conditioning“ commenting on the series of photographs of the performance underlines the silence in which the action took place, highlighting the spreading of the muteness: “In The Conditioning Pane enters a room with a metal bedframe positioned over two rows of burning candles. She lies fully clothed atop the frame and does not move or speak.“ The photographs documenting the performance at the Rodolphe Stadler Gallery in Paris built the basis of Small Inner Spaces V.
Performance Score: